|
|
|
|
|
Brain Sciences:盲法病例评估中专门化大语言模型在复杂诊断方面优于神经科医生 |
|
|
论文标题:Specialized Large Language Model Outperforms Neurologists at Complex Diagnosis in Blinded Case-Based Evaluation
论文链接:https://www.mdpi.com/2076-3425/15/4/347
期刊名:Brain Sciences
期刊主页:www.mdpi.com/journal/brainsci
一、引言
近年来,人工智能(AI),尤其是大语言模型(LLM),在医学领域展现出广阔的应用前景。然而,神经病学涉及复杂的临床症状、神经基础、跨学科整合需求以及多种辅助检查结果,对诊断推理的准确性和可靠性提出了较高要求。通用大语言模型虽然具备较强的信息处理能力,但仍未达到专业领域所需的适用性,限制了其在复杂临床诊断中的应用。
为提高大语言模型在神经病学领域的专业性与可信度,本研究采用检索增强生成(RAG)技术,将GPT-4 Turbo与经过筛选的神经病学知识库相结合,构建专门化AI诊断系统。研究通过盲法病例评估,比较该系统与神经科医生在复杂神经系统疾病鉴别诊断及最终诊断中的表现,评估其诊断准确性、响应效率及信息可靠性,以探索AI辅助临床决策的应用潜力。
二、材料与方法
本研究采用基于模拟临床病例的盲法对照评估。共邀请13名神经科医生作为评估者,其中5名为高年资住院医师,8名为已取得专科资格的神经科医生。同时,将基于GPT-4 Turbo的专门化AI系统Neura与上述神经科医生进行比较。该系统整合5部神经病学教材、《默沙东诊疗手册》神经系统疾病相关内容及维基百科资料,采用检索增强生成技术获取专业回答,并通过长期记忆与短期记忆数据库管理医学信息和对话背景。
本研究选取5个具有代表性的复杂神经系统疾病病例,涵盖神经血管疾病、神经炎症、脱髓鞘疾病、周围神经系统疾病及运动障碍等领域。每个病例分为两个诊断阶段:第一阶段根据初始临床信息提出鉴别诊断,医生仅依靠自身知识作答;第二阶段提供进一步检查结果,要求确定最终诊断,允许医生使用外部参考资料。两名资深神经科专家在不知道回答来源的情况下独立评分,并由独立研究人员核查AI回答所引用信息的准确性及可追溯性。
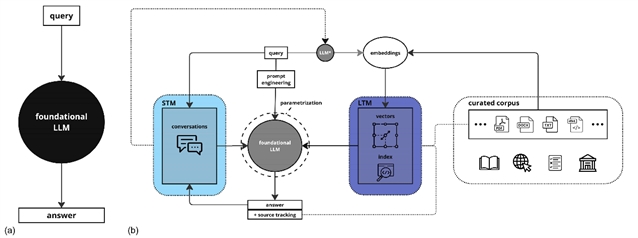
图1:(a)以黑箱方式使用大语言模型。(b)AI 解决方案的架构。LLM:大语言模型;*:用于生成嵌入的微调大语言模型;LTM:长期记忆;STM:短期记忆。
三、研究分析与结果
研究结果显示,专门化AI系统在复杂神经系统疾病诊断任务中的总体表现显著优于参与测试的神经科医生。AI系统的平均标准化得分为86.17%,而神经科医生为55.11%,差异具有统计学意义(p < 0.001)。
在鉴别诊断阶段,AI得分为85%,神经科医生为46.15%;在最终诊断阶段,AI得分为88.24%,神经科医生为70.93%。AI在两个诊断阶段均表现出较高的评分水平,但在个别病例中仍存在诊断偏差,未能给出正确结果。
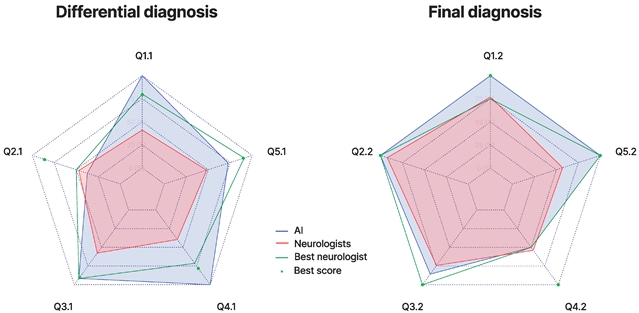
图2:雷达图展示 AI、全体神经科医生(Neurologists)、总体表现最佳的单名神经科医生(Best neurologist),以及每个问题中所有医生的最高个人得分(Best score)在鉴别诊断和最终诊断任务中的表现。每条轴对应一个问题,标记为 Qx.y(x 为病例编号,y 为诊断阶段)。得分经标准化处理,刻度间隔为 25%。
在20次独立评分中,AI获得15次满分评价,其中6次为对应问题中的唯一最高分。表现最好的神经科医生获得80.85%的总体得分,仍低于AI的86.17%。
在诊断效率方面,AI完成鉴别诊断和最终诊断的平均时间分别为28.8秒和19.2秒,而神经科医生分别需要9.62分钟和8.85分钟,表明AI在病例信息处理及诊断建议生成方面具有明显的时间优势。
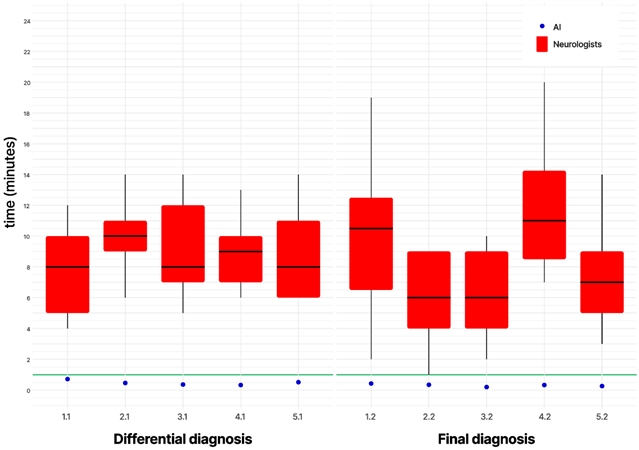
图3:箱线图展示神经科医生响应时间分布,AI 系统的响应时间以单个数据点表示,绿色水平线为 1 分钟的参考值。
此外,独立核查结果显示,AI提供的参考资料均被判定为相关,且能够支持其生成的信息。在本研究涉及的病例中,未发现虚构参考资料或相关信息,表明结合专业知识库的检索增强生成技术可提高AI回答的可验证性。
四、讨论
本研究表明,结合专业医学知识库的大语言模型能够在复杂神经系统疾病的模拟诊断任务中取得较高评分,并显著缩短信息处理时间。尤其在鉴别诊断阶段,AI能够快速整合多种疾病相关信息,提出较为全面的诊断假设,而神经科医生在获得额外临床资料并使用外部参考资源后,最终诊断得分也明显提高,体现了医学知识支持工具的重要性。
然而,AI仍存在一定局限性。例如,在部分病例中,AI提出了临床相关性不足的诊断假设,或未能在最终诊断阶段保留此前已经识别出的正确诊断。此外,本研究仅纳入13名神经科医生和5个模拟病例,样本规模较小,尚不能充分反映真实临床环境中的诊断复杂性。AI系统的表现也可能受到知识库内容、模型偏差和提示策略等因素影响,其实际临床应用效果仍需进一步验证。
五、结论
本研究发现,基于专业知识库和检索增强生成技术的专门化大语言模型,在复杂神经系统疾病的模拟诊断任务中表现出较高的诊断评分、响应效率及信息可验证性,显示出辅助神经科医生开展临床决策的潜力。然而,现有结果尚不足以证明AI能够独立承担真实临床诊断。未来仍需扩大研究样本量、纳入更多疾病类型,并开展真实临床环境下的验证,以促进AI与医学专业知识的融合,为神经系统疾病诊断提供更加高效、可靠的辅助工具。
Barrit, S.; Torcida, N.; Mazeraud, A.; Boulogne, S.; Benoit, J.; Carette, T.; Carron, T.; Delsaut, B.; Diab, E.; Kermorvant, H.; et al. Specialized Large Language Model Outperforms Neurologists at Complex Diagnosis in Blinded Case-Based Evaluation. Brain Sci. 2025, 15, 347. https://doi.org/10.3390/brainsci15040347
期刊介绍
Brain Sciences (ISSN 2076-3425) 一个专注于神经科学研究的国际性开放获取期刊,由来自美国匹兹堡大学的Stephen D. Meriney教授担任主编。期刊主要发表神经科学领域相关论文,包括但不限于认知神经科学、发育神经科学、分子与细胞神经科学、神经工程学、神经影像学、神经语言学、临床神经科学、系统神经科学、理论与计算神经科学、环境神经科学、教育神经科学、行为神经科学等多个分类和领域次级学科。
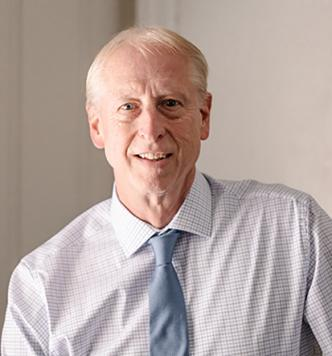
主编:Prof. Dr. Stephen D. Meriney
Department of Neuroscience, University of Pittsburgh, Pittsburgh, PA 15260, USA
2025 Impact Factor:3.4
2025 CiteScore:6.0
Time to First Decision:16.8 Days
Acceptance to Publication:2.3 Days
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。