|
|
|
|
|
大语言模型赋能地下公共空间使用后评价:从通用模型到领域适配的系统优化路径 |
|
|
地下公共空间对三维城市发展至关重要,其使用后评价(POE)构成了以人为本的规划、设计和管理的基础。尽管大型语言模型(LLM)为基于社交媒体数据(SMD)的POE提供了强大的工具,但LLM应用程序往往受到特定领域知识匮乏的限制。近日,同济大学彭芳乐教授团队在中国工程院Engineering集群子刊ENGINEERING Structure and Civil Engineering上发表了题为“How to optimize large language model performance for human-centric post-occupancy evaluation of underground public space: From model selection to model tuning”的研究论文。
研究团队开发了一个框架,用于优化基于SMD开展POE的LLM性能。使用34个地下公共空间案例和14个LLM,对两个专业标注任务的模型选择、参数设置、提示调优和微调进行了系统评估。优化策略取得了令人满意的效果,两项任务的峰值宏精度约为0.95,F1分数超过0.83。推理模型在复杂任务中的表现比通用模型高出25.74%(F1分数),尽管输出一致性较低。快速调优非常有效,但取决于任务,宏F1分数的峰值增量为21.99%。参数调优和系统角色修改的影响很小。过长的提示词可能会降低性能。微调显著提升了模型性能,减少了对提示词的依赖。POE将空间形式、寻路导向和运营管理确定为地下公共空间未来设计和改造的高优先级因素。这些发现为将LLM应用于地下空间研究中的其他类似文本分析提供了一条实用且具有成本效益的优化途径。
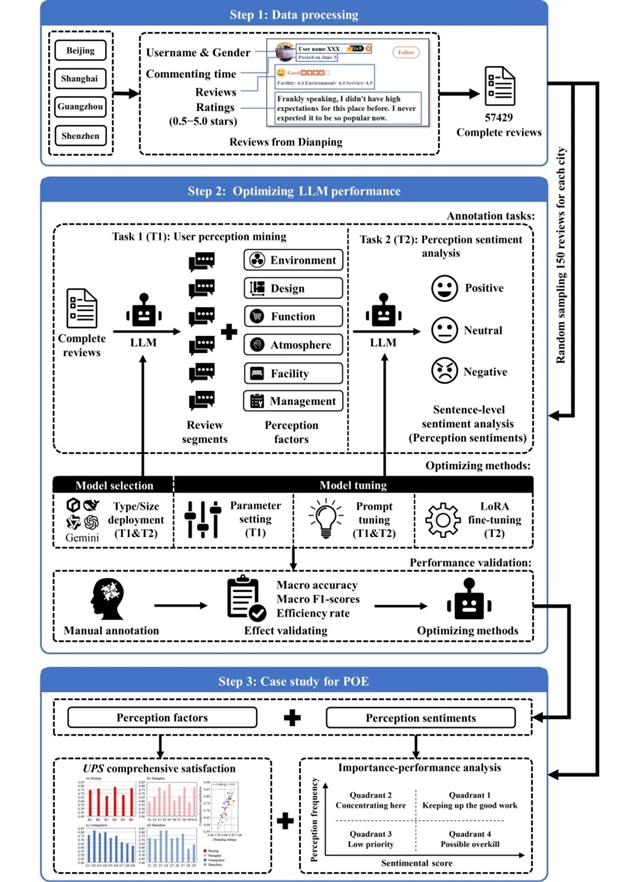
图1.研究整体分析框架
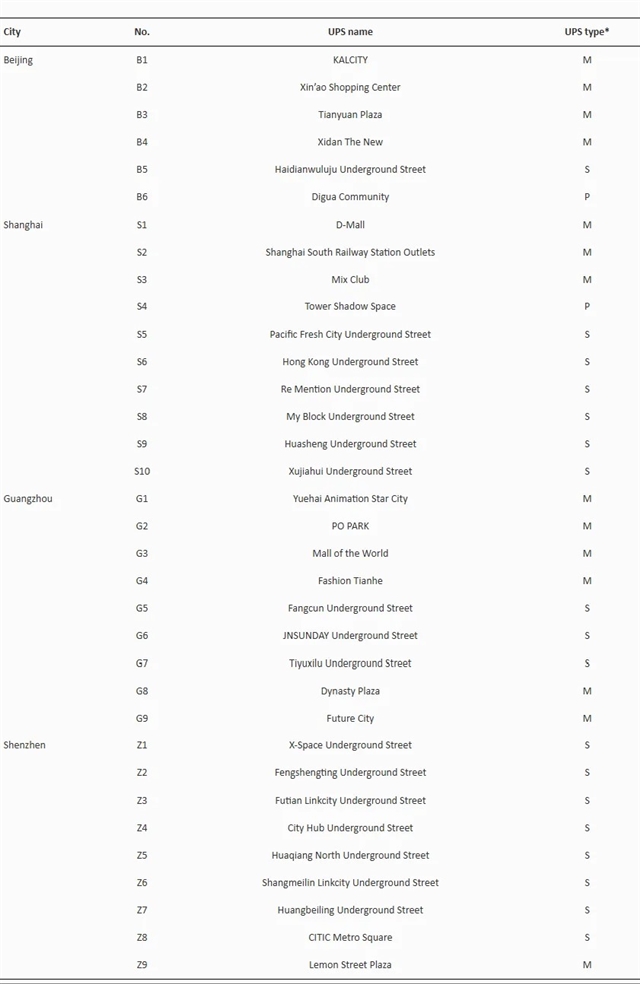
图2.研究案例
突破传统POE方法的局限
以往的地下公共空间使用后评价主要依赖问卷、访谈和现场调查,受限于样本量小、时空覆盖范围不足,难以捕捉自发的、实时的空间感知。社交媒体数据的出现为突破这一瓶颈提供了新可能,但如何从海量的非结构化文本中系统提取用户感知要素,此前缺乏成熟完整的方法论支撑。
研究团队首次将14种不同规模和类型的LLM引入地下空间POE场景,通过系统比较推理模型与通用模型在专业标注任务中的性能差异,填补了这一空白。更为关键的是,此前研究虽提及提示词调优和参数设置是LLM优化的常用手段,但缺乏定量实证分析,研究团队通过34个案例和600条测试样本的严格实验,首次量化了各优化策略的实际贡献。
揭示模型优化策略的差异化效果
在模型选择上,研究团队发现推理模型在处理复杂任务时,F1分数虽比通用模型最高提升25.74%,但输出一致性明显更弱——推理模型不一致率达45.2%,通用模型仅17.5%。这一现象揭示了LLM“概率预测”本质与专业任务对结果稳定性要求之间的矛盾。
在提示词调优上,研究团队首次区分了任务难度对优化效果的影响:专业标注任务中提供清晰标签定义可使F1分数提升21.99%,而通用情感判断任务中少量示例却更有效。研究团队首次量化了提示词的成本效益,发现系统角色修改虽绝对增益有限但效率最高,而过长提示词反而降低性能,这为研究者在经费、算力约束条件下筛选调优策略提供了实证依据。
微调的价值与POE应用新发现
研究发现模型微调可显著提升专业性能——平均准确率和F1分数平均增幅分别达12.04%和8.77%,微调后的中等规模模型甚至可超越规模大得多的未微调推理模型。这为算力有限的研究团队提供了可行路径。
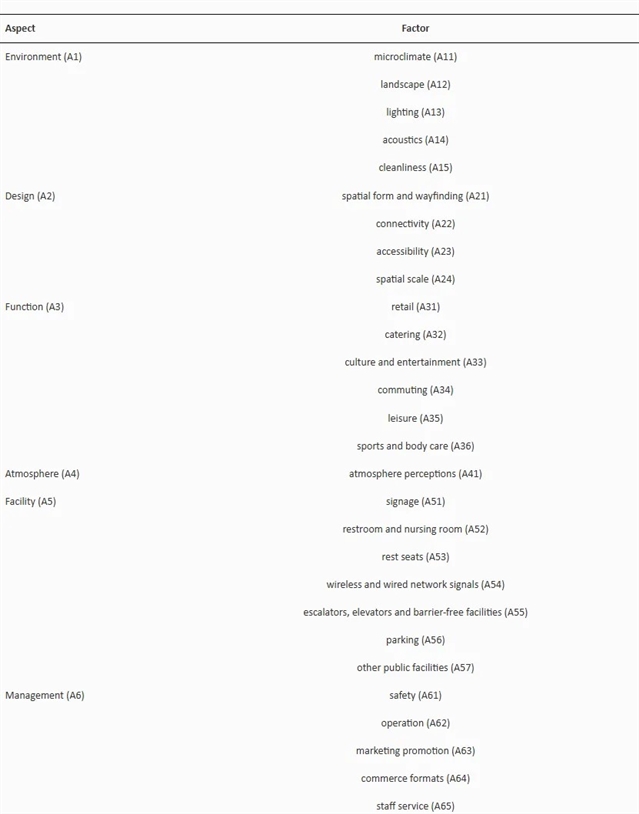
图3.UPS用户感知因素
在使用后评价实证层面,研究团队首次系统识别出“空间形式与寻路”“氛围感知”“运营管理”三个维度在四座城市中均属“高提及频次、低情绪评价”的跨区域一致特征,并揭示出地下商业街对空间连通性、地下公共服务空间对可达性的差异化需求。这些发现验证了大语言模型经系统优化后可有效服务于特定城市研究场景,为该领域从“能否用AI”转向“如何用好AI”提供了方法论参考。(来源:EngineeringJournals微信公众号)
相关论文信息:https://journal.hep.com.cn/fsce/EN/10.1007/s11709-026-1329-1