|
|
|
|
|
FCS 中国科学技术大学与 BOSS 直聘团队提出新框架,通过强化学习优化大语言模型在生成式职位推荐中的双向匹配难题 |
|
|
论文标题:Exploiting large language model with reinforcement learning for generative job recommendations
期刊:Frontiers of Computer Science
作者:Zhi Zheng, Zhao-Peng Qiu, Chen Zhu, Xiao Hu, Li-Kang Wu, Yang Song, Heng-Shu Zhu & Hui Xiong
发表时间:16 October 2025
DOI:10.1007/s11704-025-40843-1
微信链接:点击此处阅读微信文章
标题:Exploiting large language model with reinforcement learning for generative job recommendations
作者:Zhi ZHENG, Zhao-Peng QIU, Chen ZHU, Xiao HU, Li-Kang WU, Yang SONG, Heng-Shu ZHU, Hui XIONG,
DOI:10.1007/s11704-025-40843-1
扫码阅读原文↑
摘要:
职位推荐系统的核心挑战在于如何实现求职者意图与职位需求间的精准对齐。中国科学技术大学研究团队提出“双向偏好激励”新视角,将推荐过程建模为基于强化学习的生成任务。通过结合大语言模型(LLM)的语义理解能力与强化学习的反馈机制,研究团队开发了能够兼顾求职者满意度与企业需求的推荐框架,并引入了多目标奖励函数以优化推荐质量。实验证明,该方法在真实招聘场景数据集上显著提升了转化率,均优于现有的协同过滤等前沿算法。
内容精要
在线招聘领域中,生成式推荐系统面临的一个核心技术痛点是,如何在大语言模型生成的自然语言描述与复杂的岗位匹配逻辑之间建立稳健的关联。传统的判别式推荐模型虽能计算匹配概率,但在处理求职者高度个性化的意图表达以及岗位职责的语义深意时,往往表现出解释力不足。而现有的生成式方法虽具备强大的语义生成能力,但由于缺乏针对推荐目标的显式优化,容易生成表面合规但实际匹配度低的推荐结果,导致招聘效率低下。
为了解决这一难题,中国科学技术大学团队提出了结合强化学习(RL)与大语言模型的生成式职位推荐框架。该架构摒弃了单纯依赖监督微调的传统思路,转而将推荐逻辑转化为一个决策过程,利用强化学习对 LLM 的生成结果进行动态引导。框架核心设计了多维度的奖励机制,不仅包含求职者点击、应聘等硬性反馈指标,还引入了基于语义一致性的软性约束。这种设计使得模型能够通过不断的交互反馈,自适应地学习如何挖掘求职者简历中的深层技能与岗位描述之间的因果纽带。
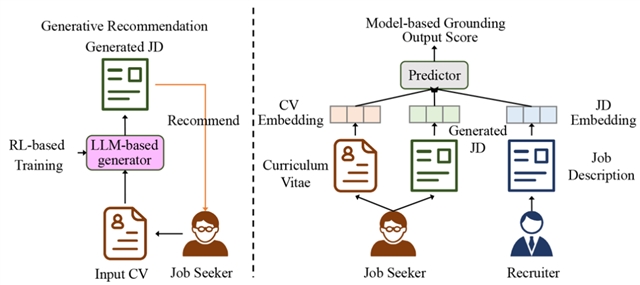
研究表明,在基于真实招聘平台的规模化数据集实验中,该方案在点击率(CTR)和成功匹配率方面均展现出显著优势。数据显示,通过强化学习微调后的模型能够更精准地捕获长尾职位的匹配特征,有效缓解了传统算法中的冷启动难题。这一研究不仅验证了强化学习在生成式推荐任务中的有效性,也为构建具备主动感知能力与闭环进化机制的智能招聘系统提供了重要的技术路径。
期刊简介
Frontiers of Computer Science (FCS)是由教育部主管、高等教育出版社和北京航空航天大学共同主办,南京大学支持,SpringerNature 公司海外发行的英文学术期刊。本刊于 2007 年创刊,月刊,全球发行。主要刊登计算机科学领域具有创新性的综述论文、研究论文等。本刊主编为周志华院士,执行主编为周昆教授。编委会及青年 AE 团队由国内外知名学者及优秀青年学者组成。本刊被 SCI、Ei、DBLP、INSPEC、SCOPUS 和中国科学引文数据库(CSCD)核心库等收录,为 CCF 推荐B类期刊;两次入选“中国科技期刊国际影响力提升计划”;入选“第4届中国国际化精品科技期刊”;两次入选“中国科技期刊卓越行动计划”(一期梯队、二期领军)。
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。