|
|
|
|
|
医疗保健大型语言模型的最新进展 | MDPI BioMedInformatics |
|
|
论文标题:Recent Advances in Large Language Models for Healthcare
论文链接:https://www.mdpi.com/2673-7426/4/2/62
期刊名:BioMedInformatics
期刊主页:https://www.mdpi.com/journal/biomedinformatics
一、引言
人工智能的进步催生了GPT-3.5、GPT-4、Bard等强大语言模型,它们在自然语言处理方面的突破对医疗领域意义重大。LLMs可用于改善患者护理、加速医学研究、辅助决策、加速诊断及提升系统效率。它们能帮助解读复杂病历、制定个性化治疗方案,并管理海量医学文献。在临床中,可辅助诊断、充当虚拟助手、生成病历摘要;在生物医学研究中,可从海量出版物中快速提取信息并生成新假设。然而,在真实临床场景中仍需严格评估,并应对伦理和技术挑战。
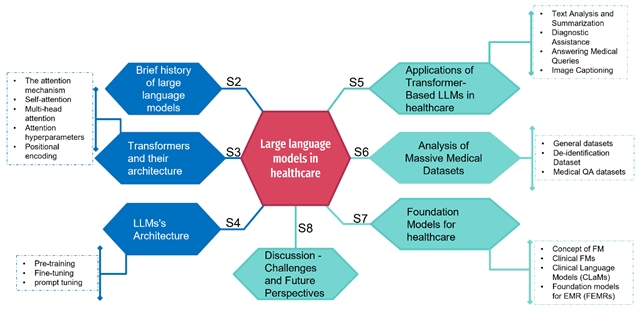
图1:结构图展示了所选论文涵盖的主题
二、主要模型架构
•GPT系列:从GPT-1(1.1亿参数)到GPT-4,逐步提升。GPT-3有1750亿参数,GPT-4参数未知但性能显著增强,可处理多模态输入,在医疗问答(如MedQA)中准确率达86.1%。
•PaLM / Med-PaLM:PaLM具有5400亿参数,采用链式思维提示。Med-PaLM通过指令微调在医学问答中表现出色,Med-PaLM M为多模态版本,可处理胸部X光、病理图像等。
•LLaMA:LLaMA-1和LLaMA-2(70亿至700亿参数),开源,训练于公开数据集。Clinical LLaMA-LoRA和PMC-LLaMA等针对临床和生物医学领域进行了微调。
•Bloom:1760亿参数的多语言模型,支持46种语言和13种编程语言。
•StableLM:开源模型,参数规模30亿至650亿,专注于对话和编码任务。
三、医疗数据集
数据集分为三大类:
•通用数据集:如MIMIC-III(重症监护数据)、MIMIC-CXR(胸部X光图像及报告)、MEDLINE(生物医学摘要)、PUBMED、NCBI疾病语料库、MEDNLI(临床自然语言推理)、MEDICAT(医学图像与标注)等。
•去标识化数据集:I2B2系列(2006-2018),涵盖去标识化、肥胖识别、药物信息提取、关系抽取、共指消解、时间关系、心脏疾病及临床试验队列选择等任务。
•医学问答数据集:包括MEDQUAD(NIH来源的问答对)、MEDMCQA(医学入学考试选择题)、MEDQA-USMLE(美国执业医师考试题)、MQP(医学问题对)、CLINIQPARA(电子病历问题改写)、VQA-RAD(放射学图像问答)、PATHVQA(病理学图像问答)、PUBMEDQA(基于摘要的问答)以及VQA-MED系列(视觉问答)和RADVISDIAL(放射学对话数据集)。
四、医疗领域应用
•文本分析与摘要:LLMs可自动提取电子病历中的关键信息,生成简明摘要,辅助医生快速掌握病史、合并症、用药及治疗反应,提升诊疗效率。还可用于放射报告简化、文献动态摘要等。
•辅助诊断:LLMs可综合医学文献、指南和病例,生成鉴别诊断列表,帮助医生选择合适检查,并与计算机辅助诊断系统结合,提升可解释性。但存在临床精确度不足、数据偏见、隐私安全等问题。
•医学问答:LLMs在MedQA等基准上取得显著进步,但存在“幻觉”问题。检索增强生成(RAG)和工具增强(如调用NCBI数据库)可减少错误,但需严格验证。
•图像描述:用于超声、X光等医学图像的自动报告生成,结合视觉与文本信息,有助于临床决策。仍面临数据集有限、评估指标不完善等挑战。
五、基础模型与临床FMs
基础模型(FMs)基于大规模预训练,可微调用于特定任务。临床语言模型(CLaMs)专门处理临床文本;电子病历基础模型(FEMRs)则整合结构化事件和临床数据,生成患者嵌入向量,用于预测住院风险等,性能优于传统方法。
六、讨论与挑战
LLMs的优势包括快速分析临床数据、为偏远地区提供初步建议、辅助医学生教育等。但主要挑战有:
•可靠性:可能误判症状,导致错误诊断。
•过度依赖:削弱医生临床判断。
•隐私保护:训练数据涉及敏感信息。
•可解释性:黑箱特性降低信任。
•伦理责任:诊断错误的责任归属问题。
缓解策略包括:差分隐私学习、可解释性技术(如热力图)、定期偏见审计、公平学习(数据多样化、重采样、多任务学习等)以及跨学科团队参与。
七、结论
LLMs(如ChatGPT、Bloom、LLaMA)在医疗领域具有巨大潜力,可改善诊断、患者护理和科研。但必须谨慎处理数据隐私、偏见和伦理问题。随着大规模公开资源训练的模型不断涌现,有望革新医疗实践,但需负责任地推动其发展。
引用格式:
Nassiri, K.; Akhloufi, M.A. Recent Advances in Large Language Models for Healthcare. BioMedInformatics 2024, 4, 1097-1143. https://doi.org/10.3390/biomedinformatics4020062
期刊介绍
主编:Dr. Alexandre G. De Brevern, 法国巴黎大学红细胞生物学研究部
BioMedInformatics (ISSN 2673-7426) 是一个跨学科的科学开放获取期刊,其使命是推动面向生物学与医学计算科学所需的多学科研究与教育范式。本刊展示基于计算机科学及相关领域的方法与成果,旨在从生物医学数据中提取信息,并将这些信息转化为知识,从而促进数据驱动的科研范式。期刊重点关注针对生物医学问题的数据驱动型解决方案——包括创新性方法与计算工作流程的开发,其侧重点至少与利用这些方法获得的特定生物医学发现具有同等学术权重。
2025 Impact Factor:3.6
2025 CiteScore:7.1
Time to First Decision:20.8 Days
Acceptance to Publication:5.6 Days
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。