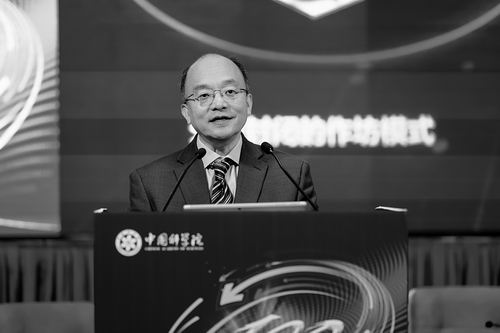
曾大军 自动化所供图
■本报记者 赵广立
一本聚焦“数据”的新刊,由世界数据组织首任理事长、中国科学院院士谭铁牛担任荣誉主编,中国科学院自动化研究所(以下简称自动化所)副所长曾大军担任主编,编委团队由来自全球20余家知名高校及科研机构的院士专家组成。它就是即将于2026年底正式与广大科研人员见面的《数据研究与应用(英文)》(Data Research and Applications,简称DRA)。
那么,这是一本什么样的期刊?DRA的创刊使命、学术定位、创新特色及未来发展是什么?在接受《中国科学报》采访时,曾大军给出了系统性回答和思考。
一本数据学术期刊的时代使命
《中国科学报》:自动化所创办一本数据研究与应用领域的国际学术期刊,是在回应科学领域的哪些现实需求?
曾大军:创办DRA回应的是AI for Science(人工智能赋能科学)时代一个被长期忽视的结构性缺口。
当科学研究从“小数据+理论演绎”转向“大数据+深度学习”,数据与模型已从论文的“补充材料”升级为科研的“基础设施”,但学术发表体系仍以论文为唯一核心。这导致一个悖论,即科研突破越来越依赖高质量数据与可复现模型,而决定科学价值的关键信息,如数据构建过程、模型训练配置、失败尝试等,却被排除在正式学术记录之外。
DRA要回应的是,让数据生产者和模型构建者的工作以独立、可引用、可评价的形态进入学术秩序。
《中国科学报》:DRA定位于“打通‘数据—研究—应用—治理’完整链路”。对此,请简要阐释一下。
曾大军:这一全链条定位的本质是将数据与模型置于科研认知链路的核心而非边缘。
传统学术期刊的定位是“我们发现了什么”,而DRA除了“我们发现了什么”之外,还注重另外3个方面,分别是“我们基于什么发现”“我们如何使发现可重复、可泛化”“数据与模型如何被可信地共享与流通”。与主流AI期刊相比,DRA对数据与模型的评审是独立学术体裁级别的严格评议,而非论文的附属语境。
更关键的是,“治理”维度的纳入,使DRA的数据论文规范天然嵌入数据确权与合规要素,这与纯学术数据期刊形成结构性差异。
《中国科学报》:DRA紧密对接国家数据要素战略与“十五五”发展规划。你如何理解科学数据期刊在国家数据战略全局中的角色与责任?
曾大军:数据已被确立为第五大生产要素。“十五五”规划纲要明确提出,建设开放共享安全的全国一体化数据市场。但要素市场的成熟不仅依赖政策与法规,还需要学术基础设施的支撑,即回答“何种数据具有科学价值”“数据质量如何评估”“数据资产如何被标准化描述并实现可信流通”等基础性问题。DRA在某种意义上正是数据要素战略在学术出版领域的制度化载体。
其责任体现在3个层面:标准层面,将数据确权元数据要素嵌入学术规范,使数据在进入学术记录之初即具备与要素市场匹配的权属信息;选题层面,围绕数据资产化、公共数据科学价值开发等议题组织跨学科学术对话,为政策提供可检验的实证基础;实践层面,通过每一次规范化的学术数据共享,对数据要素信用机制进行微观建构。
一句话总结,期刊能提供的最实质贡献不在于政策倡导,而在于持续产出可检验的制度经验。
回应“数据成果缺乏学术认可”痛点
《中国科学报》:DRA设置了六大栏目,其中“数据论文”“模型论文”以及“数据与模型更新”在传统学术期刊中并不常见。请简要介绍一下这3个栏目的设计初衷与评审标准。
曾大军:3个栏目的共同设计原则是,使数据与模型从“依附性定位”中独立出来,成为可评价、可积累、可引用的学术体裁。
“数据论文”栏目的评审标准聚焦于“该数据集为何存在、如何构建、能够回答何种问题、具有哪些已知偏差”,而非仅描述数据规模。这直接回应“数据成果缺乏学术认可”的痛点,当一个数据集以独立论文形式接受同等严格的同行评议,它便从“被引用”升级为“被评价”。
需阐明的是,数据论文的学术贡献评价不在论文内部的论述说服力,而在其被后续研究作为方法基础引用的频次与深度。
“模型论文”栏目的评审底线是“使读者在不联系作者的前提下重新运行该系统”,可复现性不构成附加优势,而是通过评审的基本门槛。
“数据与模型更新”栏目则建立迭代追踪机制,使基础设施类成果的持续贡献可被记录,而非“一次性发表即终结”。
《中国科学报》:跨学科是DRA的显著特征,但跨学科往往也带来评审标准不统一、学术话语体系差异等挑战。DRA如何应对这些挑战?
曾大军:跨学科评审的核心挑战不是标准“统一”,而是标准“可翻译”。DRA的应对策略是建立“领域敏感”的评审框架,而非用一套标准覆盖所有学科。
具体而言,数据论文的评审在数据质量维度保留学科特定的质量标准,例如医学数据的隐私合规要求与天文数据的校准标准截然不同,但在元数据完备性、可发现性、许可清晰度等基础维度上执行统一门槛。模型论文的可复现性要求同样区分层次。
此外,编委会将按学科领域分组协作,审稿人遴选坚持“领域权威+跨学科视野”双重标准。DRA的深层判断是,跨学科不是要抹平学科差异,而是要建立不同学科之间“可对话”的基础设施语言。这正是数据与模型作为学术对象能够承载的功能。
不是“又一本数据期刊”
《中国科学报》:DRA组建了高水平国际化编委团队。作为主编,你如何规划编委团队的分工与协作机制?
曾大军:DRA编委团队的分工不按“挂名职务”设计,而按“功能角色”配置。
核心机制有3个。一是“领域分组审稿”,编委按领域分组,负责各自领域数据论文与模型论文的学术把关,确保评审标准与学科前沿同步。二是“议程引领角色”,编委不仅是审稿人,也是期刊前沿议题的策源者。围绕跨领域数据互操作标准、基础模型科学适用性边界等关键瓶颈,由编委牵头组织前瞻性专题与评论,使期刊成为“什么问题重要”的议程设置者。三是“社区嵌入网络”,依托编委在全球数据科学与模型研究主要机构的学术公信力,使DRA自创刊起就嵌入全球数据科学社区的实际运转,而非作为“又一本新刊”等待被发现。
《中国科学报》:如何进一步吸引国际顶尖学者和团队参与?
曾大军:我认为吸引顶尖团队的根本不在于约稿技巧,而在于期刊能否提供传统期刊无法替代的学术价值—— 一个能让数据与模型作为完整学术成果被严格评议和正式承认的空间。
《中国科学报》:DRA未来3到5年有怎样的发展愿景?你希望它在中国乃至全球数据科学学术生态中扮演什么样的角色?
曾大军:未来3到5年,DRA的核心目标可概括为顺应AI for Science的全球发展趋势,使DRA成为数据与模型研究领域高质量成果的首选发表平台,并在此新兴学术赛道上建立具有引领性的学术话语权。
这一愿景不依赖营销驱动,而依靠每一篇发表成果的学术分量逐步累积。当国内外顶尖团队完成一个高价值数据集或基础模型的构建,如果其首要判断是“该成果应发表于DRA”,这比任何量化指标更能定义期刊的学术地位。
正如我前面所说,DRA希望扮演的角色不是“又一本数据期刊”,而是学术评价体系的结构性推动者。当足够多的研究者通过数据与模型论文的发表获得可计量的学术回报,“承认”便从愿景固化为既成事实。如果5年后,一位青年科学家在履历中列出一个被广泛引用的数据集和模型并因此获得学术认可,而不再需要以“论文”的框架为数据工作寻找合法性,DRA的存在便有了意义。
《中国科学报》 (2026-10-19 第3版 综合)