|
|
|
|
|
四川大学与中国医学科学院研究团队—G-HIV:集成长读长测序和自动化生物信息学分析,实现HIV-1的快速精准监测 | Microorganisms |
|
|
期刊名:Microorganisms
期刊主页:https://www.mdpi.com/journal/microorganisms
论文标题:G-HIV: An Integrated Long-Read Sequencing and Automated Bioinformatics Platform for Rapid and Precise HIV-1 Surveillance
论文链接:https://www.mdpi.com/2076-2607/14/9/1881
1. G-seq 500 的测序原理:为什么能“又长又准”
理解 G-HIV 的优势,先看它背后的测序仪——今是科技 G-seq 500。它采用 Nanopore Sequencing by Synthesis(NSS,纳米孔合成测序),与常规纳米孔“直接过孔”不同,NSS 把“合成”与“纳米孔电流检测”结合在一起:
1. 酶促合成:DNA 聚合酶以目标链为模板,依次加入带有特殊带电标记的 dNTP;
2. 纳米孔读取:每掺入一个碱基,其带电标记被电场拉入纳米孔蛋白,产生特征性阻塞电流;
3. AI 解码:软件把电流信号逐个还原为 A/T/C/G 序列。
为什么“长”?
NSS 基于纳米孔单分子读取,不像二代测序那样受限于几十到几百 bp 的片段化循环;本研究中 G-seq 500 产出的 EHA(extremely high accuracy)reads N50 长度达到 7,268 bp,峰值覆盖在 1,230 bp,完整覆盖了 HIV-1 pol 区(PR + 部分 RT,约 1,036 bp)绰绰有余。长读段的关键价值在于“相位保持”——同一条 read 上的所有突变天然连锁,不需要像短读段那样靠算法猜测组装,也就能直接看清一个病毒准种的完整单倍型。
为什么“准”?
G-seq 500 的文库制备会产生共价闭合环化分子(covalently closed circular molecules)。测序时,同一个环形分子可以被反复读取多次;系统对同一分子的多条子读段(subreads)进行环形一致测序(CCS)和迭代打磨(iterative polishing),生成 EHA。论文指出,在 50× 覆盖度下,一致序列准确度可超过 Q50(即碱基错误率 < 1/100,000)。简言之:同一个分子被多轮“投票”,错的自然被筛掉。这与 PacBio 的 CCS(Circular Consensus Sequencing)理念一致,但 G-seq 500 通过纳米孔-合成偶联的方式实现,在国产平台上完成了长读长与高精度的统一。
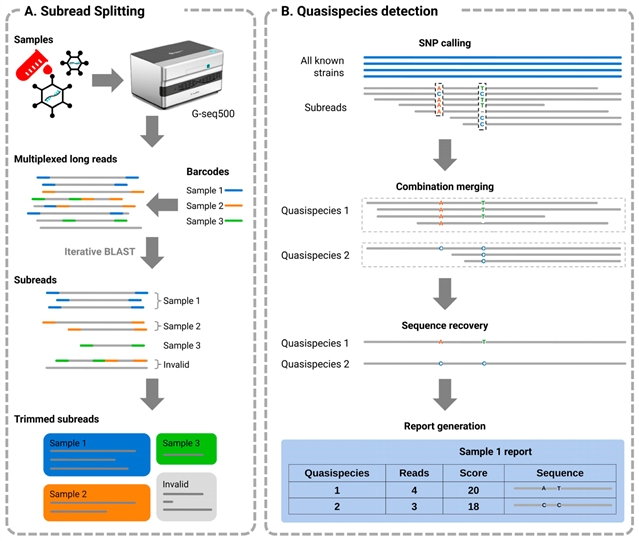
图 1|G-HIV 平台生信分析流程:从混合文库拆分、SNP calling 到准种重建与耐药报告自动生成。
2. G-HIV:把“长读长”变成“看得见的准种”
有了高质量长读段,还要有能自动分析的软件。G-HIV 的核心是两步准种推断:
第一步:把混合样本按条形码拆分,映射到 HIV-1 全参考库,识别 SNP/indel 位点;
第二步:利用长读段上变异位点的共现信息,把同一分子上的突变“串”成完整单倍型,从而重建病毒准种。
整个过程自动生成四大报告:点突变、耐药预测、准种多样性、单倍型网络。研究人员不需要自己写代码或调参数。
3. 真实样本验证:44 例四川 HIV-1 血浆
研究纳入 44 例来自四川献血者的 HIV-1 阳性血浆(2023–2024 年采集),其中 2 例 Sanger 峰图质量差被剔除,最终比较 42 例。
3.1 测序产量
G-seq 500 一次运行产出 16.25 万条 reads、79.1 亿 bp,平均 94% 的 reads 可被成功拆分;EHA 读长 N50 为 7,268 bp。44 例样本一次性上机即可完成,说明单张芯片即可高通量完成多路复用检测,在通量和成本上具备规模化潜力。
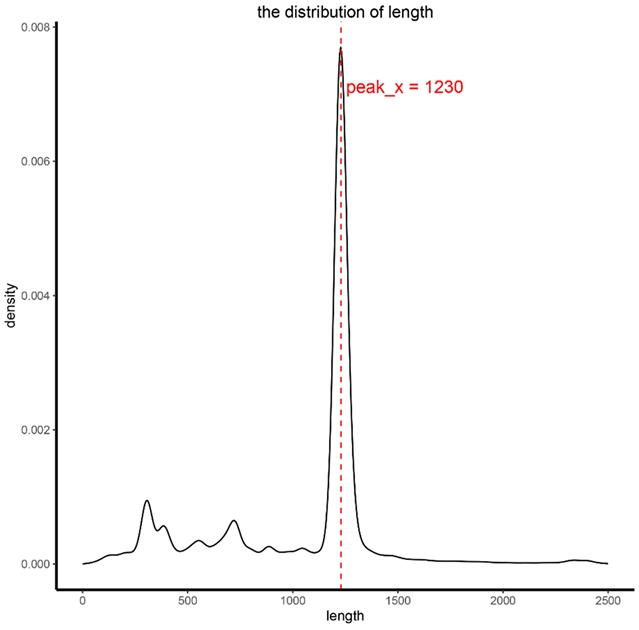
图 2|EHA 读长分布:峰值 1,230 bp,N50 达 7,268 bp。
3.2 亚型分布
G-HIV 与 Sanger 对主序列亚型判定一致。42 例样本中,CRF07_BC 占 50.0%(21/42),CRF01_AE 占 33.3%(14/42),CRF08_BC 占 9.5%(4/42),还有 CRF85_BC、B 亚型、C 亚型各 1 例,与中国西南流行特征相符。
3.3 低频变异检出能力
在 36 例 Sanger 没有明显“混合峰”的样本中,G-HIV 每例仍能检出 3–48 个候选低频变异。即使在病毒载量最低的样本 79(仅 8.82×10² IU/mL)中,也检出了 10 个 Sanger 未见的变异。这意味着:G-HIV 对早期或低载量耐药准种更敏感。
3.4 混合感染与准种溯源
Sanger 的混合峰只能提示“有杂合信号”,却无法区分是单纯准种混合还是真的两种病毒共感染。G-HIV 借助长读段单倍型重建,能把不同来源的病毒“拆”开。
样本 18:8 条准种序列聚类成两个 CRF07_BC 支系,提示同一亚型内的共感染;
样本 22:2 条准种分别落在 CRF07_BC 和 CRF08_BC 支系,提示不同亚型间的共感染/重叠感染。
系统发育树 + 单倍型网络的双重可视化,让传播链推断有了更可靠的证据。
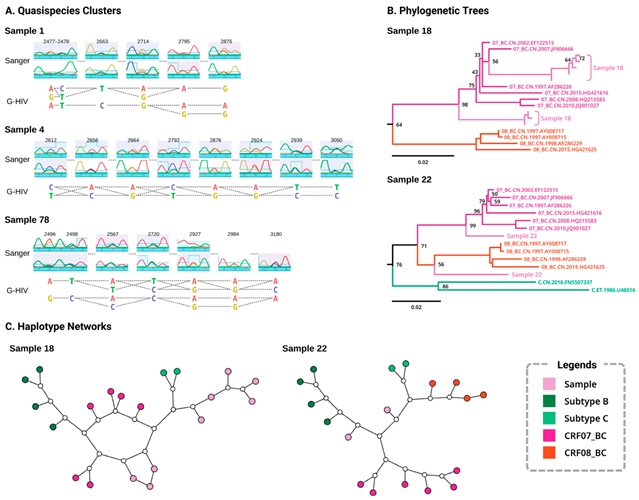
图 3|混合感染与准种识别:Sanger 峰图、G-HIV 分相结果、系统发育树与单倍型网络。
3.5 耐药结果
42 例中仅 4 例携带中/高度耐药突变(样本 69、71、73、76)。值得注意的是:
1. 样本 69、76 中部分耐药准种未被 Sanger 检出;
2. 同一样本内可同时存在耐药与敏感准种,反映抗病毒治疗压力下的分子进化。
这一点在临床上非常重要。基线时被 Sanger“漏掉”的耐药准种,可能在抗病毒药物选择压力下迅速扩增,导致早期治疗失败。G-HIV 的高灵敏度有助于在启动 ART 前识别这些“隐形耐药”,为个体化用药提供依据。
|
Sample No.
|
Number of Quasispecies
|
High Drug Resistance
|
Moderate Drug Resistance
|
Detectable by Sanger Sequencing
|
|
69
|
2
|
EFV, NVP
|
–
|
Yes
|
|
EFV, NVP
|
–
|
No
|
|
71
|
3
|
NVP
|
EFV, ETR, RPV
|
Yes
|
|
–
|
–
|
No
|
|
–
|
–
|
No
|
|
73
|
3
|
EFV, NVP
|
–
|
Yes
|
|
EFV, NVP
|
–
|
Yes
|
|
–
|
–
|
No
|
|
76
|
3
|
AZT, EFV, NVP
|
D4T, DOR
|
Yes
|
|
AZT, EFV, NVP
|
D4T, DOR
|
No
|
|
AZT
|
D4T, EFV, NVP
|
No
|
表 2|4 例耐药样本的准种与耐药谱:G-HIV 发现了 Sanger 未检出的耐药准种
4. G-HIV 的临床价值:让基层也能做精准耐药监测
论文讨论部分指出,中国 HIV 传播耐药率已从 2020–2022 年的 7.8% 升至 2023 年的 11.4%。耐药监测通常集中到省级或国家实验室, turnaround 时间可长达两个月。G-HIV 把“样本→报告”压缩到 1 天内,且不需要专业生信人员,正好契合基层疾控和输血机构的需求。
此外,G-HIV 输出的单倍型网络(haplotype network)和系统发育树,可直接用于分子流行病学溯源。在司法流行病学、输血安全评估和聚集性疫情调查中,这种“读得到、分得清、看得见”的证据链尤为珍贵。
当然,研究也坦承局限:样本量偏小、仅限于四川地区、未与 Illumina MiSeq 直接头对头比较、未加 UMI 校正 PCR 错误。这些都是未来多中心扩大验证的方向。
总结
G-HIV :基于今是 G-seq 500 的“长而准”单分子读段 + 自动化生信流水线,在 HIV-1 耐药、准种和共感染监测上,比 Sanger 更灵敏、比传统 NGS 更易用,有望把精准耐药监测推向基层一线实验室。
Microorganisms期刊介绍
主编:Nico Jehmlich, UFZ-Helmholtz Centre for Environmental Research, Germany
期刊主题涵盖微生物学的各个研究领域,主要发表环境、植物、食品、肠道、医药、技术等微生物相关领域的学术文章。现已被SCIE (Web of Science)、PubMed (NLM)、Scopus等重要数据库收录。
|
2025 Impact Factor
|
4.7
|
|
2025 CiteScore
|
8.2
|
|
Time to First Decision
|
16.5 Days
|
|
Acceptance to Publication
|
3.3 Days
|
欢迎订阅Microorganisms期刊最新资讯:
https://www.mdpi.com/journal/microorganisms#journal-alerts
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。